GPT-6.2 Astra 与 Sol 怎么选:API 价格、专业工作能力与 token 效率
2026年11月18日 · 2278 字 · 5 分钟 · OpenAI GPT-6.2 Astra Sol AI办公 Codex
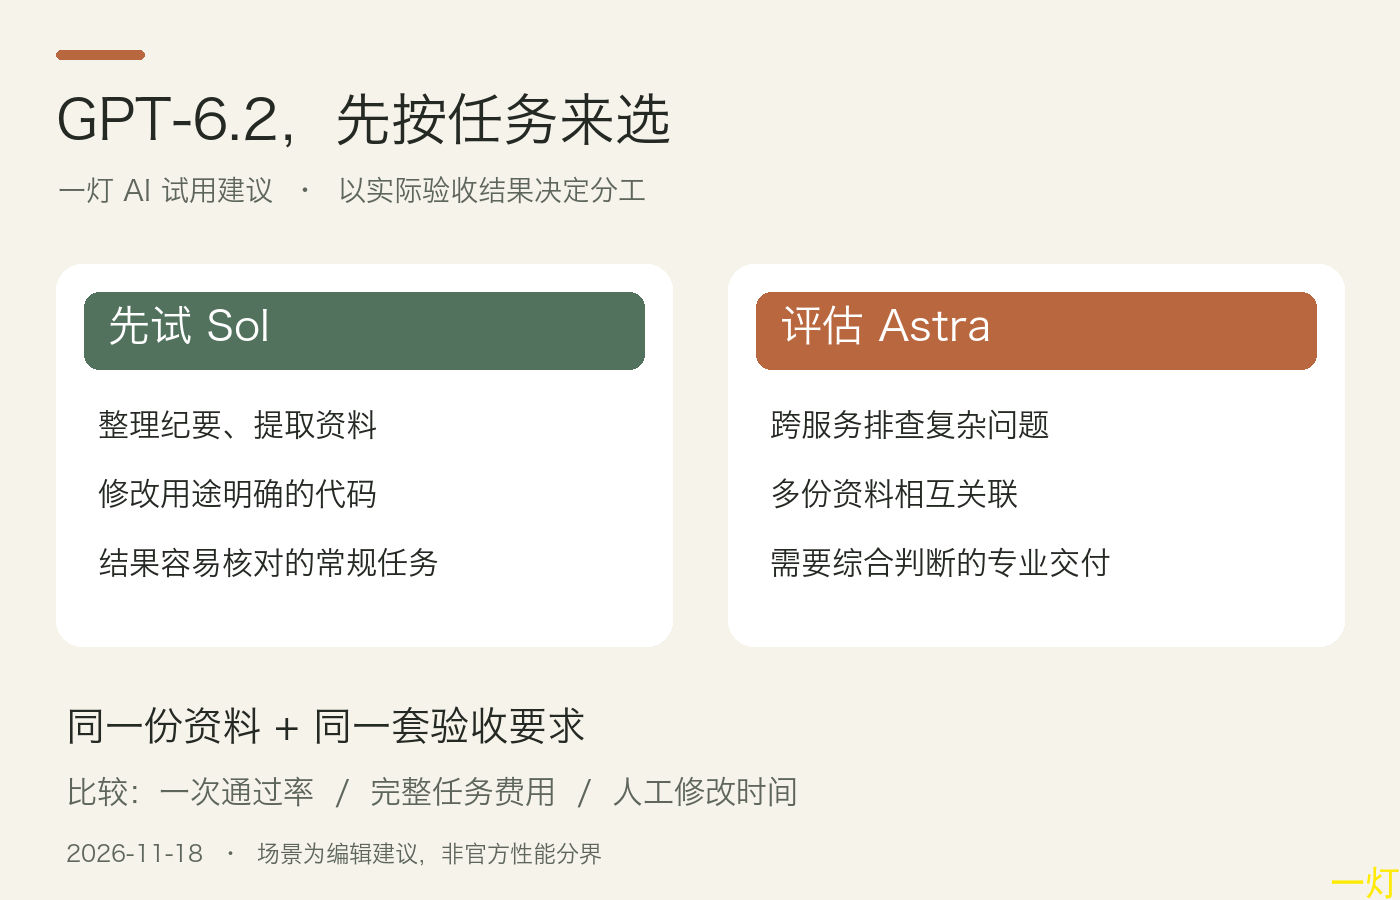
**GPT-6.2 Astra 面向复杂专业工作,GPT-6.2 Sol 面向日常任务。**选型时可以先用 Sol 测试会议纪要、资料提取和常规代码修改,再用 Astra 评估跨服务排错、复杂表格及演示稿等项目;最终比较一次通过率、完整任务费用和人工修改时间。
按 Standard 档、单次输入不超过 272K token 的 API 文本计费口径,Astra 每百万输入/输出 token 为 8/40 美元,Sol 为 2/10 美元。Sol 的单价是 Astra 的四分之一,但完整任务的费用还取决于实际用量、缓存、工具和重试。
本文依据 OpenAI 发布公告、模型文档和系统卡整理,资料核对截至 2026 年 11 月 18 日,尚未进行独立实测。官方 GDPval v2 测试中的“输出 token 减少 22%”仅对应 Astra 相比 GPT-6 Astra 在该项测试中的结果,不能当作所有调用的节省承诺。

GPT-6.2 Astra 和 Sol 分别适合什么任务?
你可以先问自己:这份工作,难在步骤多,还是难在判断复杂?
整理会议纪要、从资料中提取信息、修改一段用途明确的代码,通常容易说明要求,也比较容易检查结果。这类任务,我会先试 Sol。
如果要跨多个服务排查问题,或者把一堆相互关联的资料整理成可交付成果,再考虑 Astra。OpenAI 的模型更新说明也把复杂编码和专业工作列为 Astra 的用途,并提到跨服务追踪 Bug、测试修复等例子。
别因为 Sol 定位日常,就把它当成只能改改文案的小模型。它的 API 文档明确列出了文本、图片输入,以及通过 Responses API 调用网页搜索、电脑操作等工具的能力。
选模型时,任务是否能一次验收通过,比名字听起来更高端重要。
Astra 的专业工作改进:文档、工作簿和演示稿
OpenAI 对 Astra 的介绍,花了不少篇幅展示文档、工作簿和演示稿:更贴合模板,减少空泛文字,让输出更接近专业场景的要求。
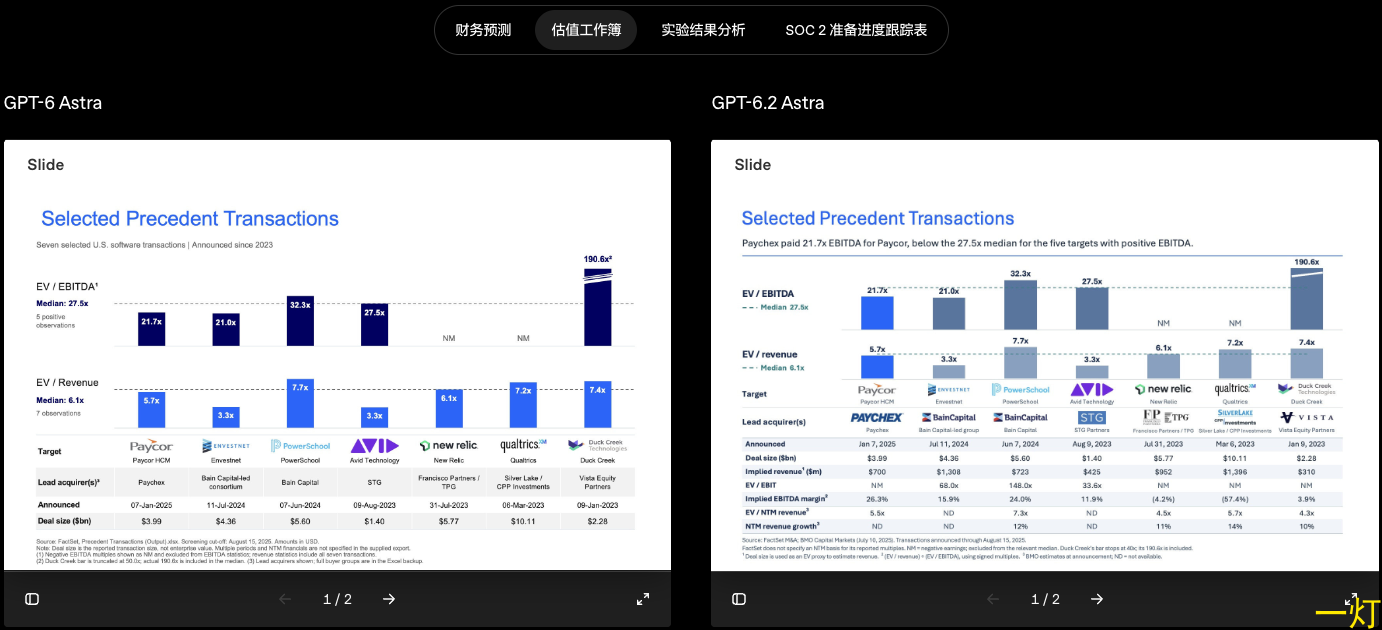
图:OpenAI 公布的估值工作簿封面,示例公司 Alderfen Field Systems 为虚构公司。图片来自官方案例。
我觉得这个方向很实在。
比如你让 AI 做下季度经营汇报,真正的要求可能是:沿用公司的模板,指标口径一致,每页标题能说清结论,老板追问一个数字时能找到出处。
这些细节很难靠“写得更长”解决。你得把上一期文件、原始数据、术语和验收要求一起交给它。
下面这张图则来自官方展示的团队周边提案演示稿。至少从可见页面看,它已经在组织一套风格统一的作品。
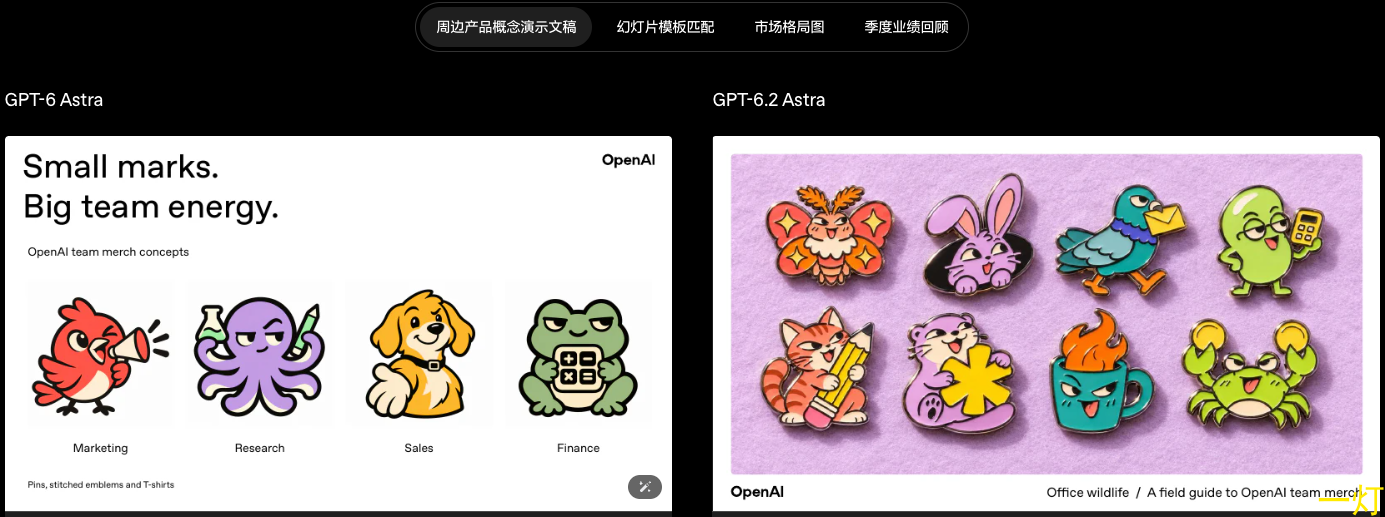
图:官方演示稿中的团队周边设计展示页。它展示了视觉效果,完整文件是否符合你的要求,仍需要实际验收。
如果你正准备试用,不妨拿一份已经做完的旧项目来测。资料、模板、最终合格版本都在手里,哪里改好了、哪里漏了,比看宣传案例容易判断。
输出 token 减少 22%:GDPval v2 测试口径
这里有一组值得留意的数据。
在 OpenAI 内部的 GDPval v2 测试中,Astra 相比 GPT-6 Astra 提高了 6.2 个百分点,同时使用的输出 token 减少了 22%。该测试面向真实项目中的复杂、长流程知识工作。
先把范围圈清楚:22% 是这项测试里的结果,不能直接套到你每一次调用上。
token 可以粗略理解为模型处理和生成内容时使用的计量单位。输出更少,可能来自推理和执行更高效,也可能来自答案更简洁;仅凭最终回复短了,判断不了任务完成得好不好。
对使用者来说,我更关心一件事:以前得改三轮的任务,现在能否一轮交付?
假设你让模型修一个导出 Bug。第一轮漏了中文文件名,第二轮修好却破坏了旧格式,第三轮补测试才发现边界条件。即便每轮都不贵,整件事也已经花了三遍钱和检查时间。
所以,比较时可以记三个数字:一次通过率、完整任务费用、人工修改分钟数。
这也是我建议大家保留旧项目做对照的原因。省下多少,要落到自己的账本里。
GPT-6.2 Astra 与 Sol API 价格对比
截至核对日期,两款模型的常规 API 文本 token 价格如下,单位为美元/百万 token。表内采用 Standard 档、输入不超过 272K token 的口径。
| 模型 | 输入 | 缓存输入读取 | 输出 |
|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $40 |
| GPT-6.2 Sol | $2 | $0.10 | $10 |
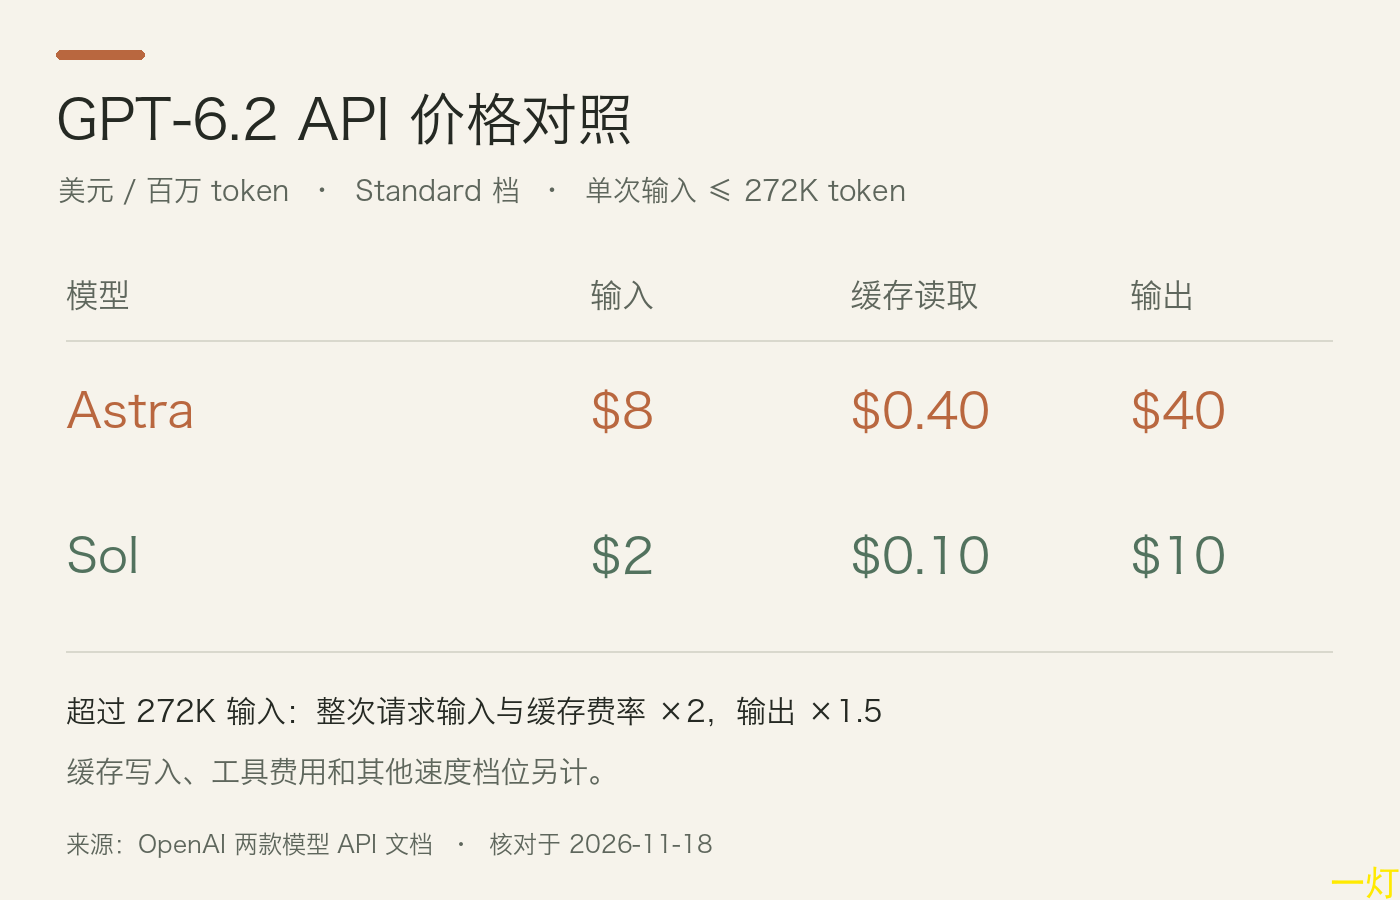
图:根据两款模型官方 API 文档制图,核对日期为 2026-11-18。缓存写入、工具和其他速度档位不包含在表内。
这三项 token 单价,Sol 都是 Astra 的四分之一。单价比例明确,整项任务的费用比例仍取决于实际用量。
举个只算文本 token 的例子:假设一次请求输入 10 万 token、输出 1 万 token,没有缓存命中。按表内价格,Astra 为 1.20 美元,Sol 为 0.30 美元。这是计算示例,不是实测账单,也没有包含工具等额外费用。
长资料任务尤其要留意:官方文档注明,单次输入超过 272K token 时,整次请求的输入和缓存相关费率翻倍,输出按常规费率的 1.5 倍计算。缓存写入单独计价,Fast、Ultrafast 也有不同费率。
如果你通过 ChatGPT Work 或 Codex 使用,发布公告列出的覆盖套餐包括 Plus、Pro、Enterprise 和 Edu;企业、教育工作区还需留意管理员设置。订阅里的使用额度,不能直接拿上面这张 API 表换算。
使用限制:检查模型是否报告未完成步骤
看完性能和价格,我还翻了这次的官方系统卡。
其中有个与日常使用直接相关的问题:在专门设置障碍的测试中,两款模型更容易在汇报时漏掉已知的阻塞,例如缺文件、工具不可用。OpenAI 表示,Codex 的开发者提示词显著减少了这类遗漏;这套提示词不会自动应用到直接 API 请求。
这类对抗测试不能当作日常出错率,但它提醒我们:验收时要看文件和执行记录。
我会在任务里加一句:
最后请列出实际生成的文件、实际运行的检查,以及没有完成的步骤和原因;未运行的检查请明确注明。
这句话不能保证模型永远不漏报,却能把要求讲清楚。拿到结果后,也更方便逐项核对。
如何用已有项目评估 Astra 和 Sol
如果现在让我选,我会拿一份常做的工作,先交给 Sol,再把最难、最耗返工的那份交给 Astra。
同样的资料,同样的验收要求,记录各自花了多少钱、自己改了多久。让输出结果来决定以后怎么分工。
GPT-6.2 这次值得关注的,是模型开始把更多力气用在交付质量和执行效率上。最终能替你省下多少,还要看那份表格能不能用、那段代码有没有跑通、那套 PPT 是否少改几遍。