Claude Fable 5.2 上线:100 万上下文、定价与三层任务分工
2026年11月10日 · 1913 字 · 4 分钟 · Anthropic Claude Claude Fable AI编程 模型选型
Anthropic 于 2026 年 11 月 9 日正式发布 Claude Fable 5.2 与 Claude Mythos 5.2。
官方将其定位在 Haiku、Sonnet 与 Opus 之上,配备了 100 万 token 的上下文窗口与自适应长程推理能力。
很多人的第一反应是在网页端或终端代码助手里第一时间切到最新款。但如果只是为了顺手改两句文案、写个简单函数,或者总结一段半小时的会议记录,完全没有必要特意换上它。
这两个大模型面向的是高复杂度工程,单次调用成本并不低。把日常小活全甩过去,账单会迅速上涨,实际响应速度也未必比轻量模型顺手。
信息来源:
Anthropic 官方公告:https://www.anthropic.com/claude-fable-and-mythos-5-2
先看清谁能用:同一套底牌,两种开放规则
Fable 5.2 与 Mythos 5.2 底层使用的是同一套顶峰模型权重与推理能力。
两者的区别主要在于安全机制与开放对象:
- Claude Fable 5.2:面向普通开发者和付费用户全量开放。无论是在 Claude 网页端、Claude Code 终端还是各大云平台的 API,都能直接调用。它内置了严格的生产级网络安全与生物安全防御体系。
- Claude Mythos 5.2:专为通过专门审核计划(Cyber 或 Life Sciences Verification Program)的企业与科研机构开放,放宽了部分安全拦截,供防御性网络安全研究或生命科学实验室使用。普通团队基本申请不到,日常业务也确实用不上。
因此,开发者和技术团队关注 Fable 5.2 即可,无需花时间申请 Mythos 的特种权限。
百万级上下文,适合解决什么样的难题?
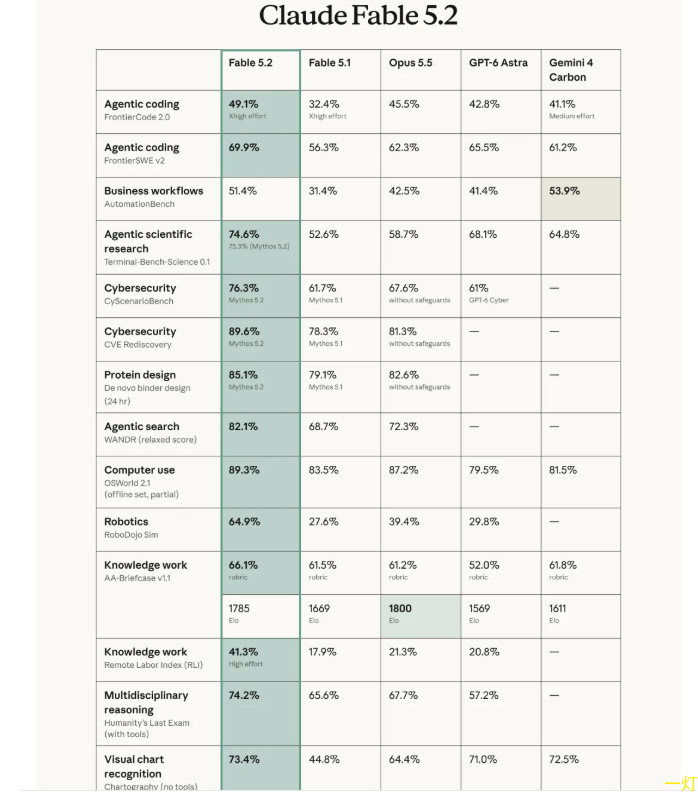
在官方模型梯队中,Fable 5.2 排在 Opus 系列之上。
它支持 100 万 token(1M)超长上下文窗口,并引入了更成熟的自适应推理机制(adaptive thinking),输出速度较 5.1 代提升了约 30%。
真正值得调用它的,往往是下面这类消耗脑力的硬骨头:
- 几十万行旧工程的跨模块大型框架迁移
- 牵扯几十个代码文件、难以复现的偶发性死锁与隐蔽 Bug
- 需要长时间保持思路连贯的多智能体(multi-agent)复杂研发协作
- 从零构思复杂电子设备或高精度系统设计
这类任务的共同点是上下文极长、链路极深,常规模型推演到一半往往容易遗忘上下文或产生幻觉。
对于绝大多数日常编码和知识类任务,官方自己的建议依然很务实:先从 Opus 5.5 之类成熟的主力模型入手;只有当问题极其复杂、卡壳几天推进不下去时,再调出 Fable 5.2 解决。
算清账单:价格别只看单价
想把高能力模型用顺手,关键是看清计费逻辑:
- 标准模式:每百万输入 token 8 美元,输出 token 40 美元。
- 极速模式(Fast Mode):生成速度最高提升至 2.5 倍,但计费直接翻倍为每百万输入 16 美元、输出 80 美元。
单看表面数字可能感觉还好,但 100 万的大上下文如果缺乏约束,token 消耗速度会远超预期。
如果丢给它一句模糊的需求:“先看下我们整个工程,把能优化的地方都整理出来”,模型会在长上下文里反复发散推演,几次交互下来账单就上去了,产出的改动大概率还不敢直接合并进主分支。
调用贵模型前,先明确验收标准和改动边界。
例如:提前圈定不能变动的公共接口、指定依赖版本、给出明确的报错日志,以及要求通过的具体测试用例。把边界锁死,算力才能集中用来解决实际卡点,而不是在猜测意图上反复空转。
团队里的三层任务分流法
很多团队觉得大模型用起来成本不可控,常见原因就是所有人都用同一个顶配模型处理所有事情。
根据任务难度做分层流转,通常更划算:
- 轻快响应层:格式转换、单函数补全、常规测试用例编写。优先选响应极快、成本微弱的轻量模型(如 Haiku / Flash 系列)。
- 主力日常层:常规功能模块开发、需求逻辑拆解、日常代码审查。使用理解力扎实的主力模型(如 Opus 5.5 或 Sonnet 系列)。
- 高难度破局层:架构重构、深层性能瓶颈、长链路多智能体原型。这时候再由 Fable 5.2 集中攻坚。
分流清楚之后,既能控制整体开销,也不耽误攻坚效率。
给团队的一次低成本尝试方案
如果你打算在团队里试用 Fable 5.2,不用一上来就拿核心业务冒险。
可以挑一个手头现成的、能够独立闭环的任务做测试:
- 找一个困扰团队几天、排查链路复杂的偶发报错;
- 准备好最小复现代码片段、报错堆栈和期望的运行结果;
- 交给 Fable 5.2,要求它先说明分析推导逻辑与影响范围,再给出修复补丁与测试用例。
最后记录三个指标即可:解决耗时、人工追问轮数,以及最终补丁的可用程度。
如果它确实能把资深工程师从反复排查中解放出来,这份调用开销才算花得有价值。
常见问题(FAQ)
Fable 5.2 和 Mythos 5.2 的核心区别是什么?
两者模型权重与底层能力完全相同,主要区别在于开放对象和安全策略。Fable 5.2 具备完整的网络与生物安全拦截,面向全体开发者与普通用户开放;Mythos 5.2 仅面向通过特定核验的企业与科研机构开放。
日常写代码应该默认使用 Fable 5.2 吗?
不建议。日常编码首选 Opus 5.5 或 Sonnet 等主力模型,速度快且成本更可控;仅在面对跨文件超大工程迁移、难以定位的偶发死锁或长链路多智能体协作时,再切换至 Fable 5.2。